Mono为何能跨平台?聊聊CIL(MSIL)

转载自CNBLOGS, 原作者 慕容小匹夫

前言:

其实小匹夫在U3D的开发中一直对U3D的跨平台能力很好奇。到底是什么原理使得U3D可以跨平台呢?后来发现了Mono的作用,并进一步了解到了 CIL的存在。所以,作为一个对Unity3D跨平台能力感兴趣的U3D程序猿,小匹夫如何能不关注CIL这个话题呢?那么下面各位看官就拾起语文老师教 导我们的作文口诀(Why,What,How),和小匹夫一起走进CIL的世界吧~

Why?

回到本文的题目,U3D或者说Mono的跨平台是如何做到的?

如果换做小匹夫或者看官你来做,应该怎么实现一套代码对应多种平台呢?

其实原理想想也简单,生活中也有很多可以参考的例子,比如下图(谁让小匹夫是做移动端开发的呢,只能物尽其用从自己身边找例子了T.T):
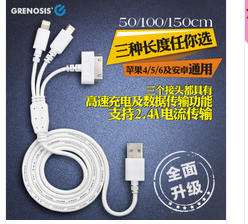
像这样一根线,管你是安卓还是ios都能充电。所以从这个意义上,这货也实现了跨平台。那么我们能从它身上学到什么呢?对的,那就是从一样的能源(电)到不同的平台(ios,安卓)之间需要一个中间层过度转换一下。

那么来到U3D为何能跨平台,简而言之,其实现原理在于使用了叫CIL(Common Intermediate Language通用中间语言,也叫做MSIL微软中间语言)的一种代码指令集,CIL可以在任何支持CLI(Common Language Infrastructure,通用语言基础结构)的环境中运行,就像.NET是微软对这一标准的实现,Mono则是对CLI的又一实现。由于CIL能运 行在所有支持CLI的环境中,例如刚刚提到的.NET运行时以及Mono运行时,也就是说和具体的平台或者CPU无关。这样就无需根据平台的不同而部署不 同的内容了。所以到这里,各位也应该恍然大了。代码的编译只需要分为两部分就好了嘛:

  1. 从代码本身到CIL的编译(其实之后CIL还会被编译成一种位元码,生成一个CLI assembly)
  2. 运行时从CIL(其实是CLI assembly,不过为了直观理解,不必纠结这种细节)到本地指令的即时编译(这就引出了为何U3D官方没有提供热更新的原因:在iOS平台中Mono无法使用JIT引擎,而是以Full AOT模式运行的,所以此处说的额即时编译不包括IOS)

What?

上文也说了CIL是指令集,但是不是还是太模糊了呢?所以语文老师教导我们,描述一个东西时肯定要先从外貌写起。遵循老师的教导,我们不妨先通过工具来看看CIL到底长什么样。

工具就是ildasm了。下面小匹夫写一个简单的.cs看看生成的CIL代码长什么样。

C#代码:

class Class1
{
    public static void Main(string[] args)
    {
        System.Console.WriteLine("hi");
    }
}

CIL代码:

.class private auto ansi beforefieldinit Class1
       extends [mscorlib]System.Object
{
  .method public hidebysig static void  Main(string[] args) cil managed
  {
    .entrypoint
    // 代码大小       13 (0xd)
    .maxstack  8
    IL_0000:  nop
    IL_0001:  ldstr      "hi"
    IL_0006:  call       void [mscorlib]System.Console::WriteLine(string)
    IL_000b:  nop
    IL_000c:  ret
  } // end of method Class1::Main

  .method public hidebysig specialname rtspecialname 
          instance void  .ctor() cil managed
  {
    // 代码大小       7 (0x7)
    .maxstack  8
    IL_0000:  ldarg.0
    IL_0001:  call       instance void [mscorlib]System.Object::.ctor()
    IL_0006:  ret
  } // end of method Class1::.ctor

} // end of class Class1

好啦。代码虽然简单,但是也能说明足够多的问题。那么和CIL的第一次亲密接触,能给我们留下什么直观的印象呢?

  1. 以“.”一个点号开头的,例如上面这份代码中的:.class、.method 。我们称之为CIL指令(directive),用于描述.NET程序集总体结构的标记。为啥需要它呢?因为你总得告诉编译器你处理的是啥吧。
  2. 貌似CIL代码中还看到了private、public这样的身影。姑且称之为CIL特性(attribute)。它的作用也很好理解,通过CIL指令并不能完全说明.NET成员和类,针对CIL指令进行补充说明成员或者类的特性的。市面上常见的还有:extends,implements等等。
  3. 每一行CIL代码基本都有的,对,那就是CIL操作码咯。小匹夫从网上找了一份汉化的操作码表放在附录部分,当然英文版的你的vs就有。

直观的印象有了,但是离我们的短期目标,说清楚(或者说介绍个大概)CIL是What,甚至是终极目标,搞明白Uniyt3D为何能跨平台还有2万4千9百里的距离。

好啦,话不多说,继续乱侃。

参照附录中的操作码表,对照可以总结出一份更易读的表格。那就是如下的表啦。

主要操作 操作数范围/条件 操作数类型 操作数
缩写 全称 含义 缩写 全称 含义 缩写 全称 含义 缩写 全称 含义
ld load 将操作数压到堆栈当中,相当于:
push ax
arg argument 参数 ? ? 操作数中的数值 .0 ? 第零个参数
.1 ? 第一个参数
.2 ? 第二个参数
.3 ? 第三个参数
.s xx (short) 参数xx
a address 操作数的地址 只有 .s xx,参见ldarg.s
loc local 局部变量 参见ldarg
fld field 字段(类的全局变量) 参见ldarg xx ? xx字段,eg:
ldfld xx
c const 常量 .i4 int 4 bytes C#里面的int,其他的类型例如short需要通过conv转换 .m1 minus 1 -1
.0 ? 0
.1 ? 1
 ……
.8 8
.s (short) 后面跟一个字节以内的整型数值(有符号的)
? ? 后面跟四个字节的整型数值
.i8 int 8 bytes C#里面的long ? ? 后面跟八个字节的整型数值
.r4 real 4 bytes C#里面的float ? ? 后面跟四个字节的浮点数值
.r8 real 8 bytes C#里面的double ? ? 后面跟八个字节的浮点数值
null null 空值(也就是0) ? ? ? ? ? ?
st store 计算堆栈的顶部弹出当前值,相当于:
pop ax
参见ld
conv convert 数值类型转换,仅仅用纯粹的数值类型间的转换,例如int/float等 ? ? ? .i1 int 1 bytes C#里面的sbyte ? ? ?
.i2 int 2 bytes C#里面的short
.i4 int 4 bytes C#里面的int
.i8 int 8 bytes C#里面的long
.r4 real 4 bytes C#里面的float
.r8 real 8 bytes C#里面的double
.u4 uint 4 bytes C#里面的uint
.u8 uint 8 bytes C#里面的ulong
b/br branch 条件和无条件跳转,相当于:
jmp/jxx label_jump
br ? ? 无条件跳转 ? ? ? ? ? 后面跟四个字节的偏移量(有符号)
.s (short) 后面跟一个字节的偏移量(有符号)
false false 值为零的时候跳转 ? ? ? 参见br
true true 值不为零的时候跳转 ? ? ?
b eq equal to 相等 ? ? ?
ne not equal to 不相等 un unsigned or unordered 无氟好的(对于整数)或者无序的(对于浮点)
gt greater than 大于
lt less than 小于
ge greater than or equal to 大于等于
le less than or equal to 小于等于
call call 调用 ? ? ? ? ? (非虚函数) ?
? ? ? virt virtual 虚函数

在此,小匹夫想请各位认真读表,然后心中默数3个数,最后看看都能发现些什么。

基于堆栈

如果是小匹夫的话,第一感觉就是基本每一条描述中都包含一个”栈“。不错,CIL是基于堆栈的,也就是说CIL的VM(mono运行时)是一个栈式机。这就意味着数据是推入堆栈,通过堆栈来操作的,而非通过CPU的寄存器来操作,这更加验证了其和具体的CPU架构没有关系。为了说明这一点,小匹夫举个例子好啦。

大学时候学单片机(大概是8086,记不清了)的时候记得做加法大概是这样的:

add eax,-2

其中的eax是啥?寄存器。所以如果CIL处理数据要通过cpu的寄存器的话,那也就不可能和cpu的架构无关了。

当然,CIL之所以是基于堆栈而非CPU的另一个原因是相比较于cpu的寄存器,操作堆栈实在太简单了。回到刚才小匹夫说的大学时候曾经学过的单片 机那门课程上,当时记得各种寄存器,各种标志位,各种。。。,而堆栈只需要简单的压栈和弹出,因此对于虚拟机的实现来说是再合适不过了。所以想要更具体的 了解CIL基于堆栈这一点,各位可以去看一下堆栈方面的内容。这里小匹夫就不拓展了。

面向对象

那么第二感觉呢?貌似附录的表中有new对象的语句呀。嗯,的确,CIL同样是面向对象的。

这意味着什么呢?那就是在CIL中你可以创建对象,调用对象的方法,访问对象的成员。而这里需要注意的就是对方法的调用。

回到上表中的右上角。对,就是对参数的操作部分。静态方法和实例方法是不同的哦~

  1. 静态方法:ldarg.0么有被占用,所以参数从ldarg.0开始。
  2. 实例方法:ldarg.0是被this占用的,也就是说实际上的参数是从ldarg.1开始的。

举个例子:假设你有一个类Murong中有一个静态方法Add(int32 a, int32 b),实现的内容就如同它的名字一样使两个数相加,所以需要2个参数。和一个实例方法TellName(string name),这个方法会告诉你传入的名字。

class  Murong
{
    public void TellName(string name)
    {
        System.Console.WriteLine(name);
    }

    public static int Add(int a, int b)
    {
       return a + b;
    }
}

静态方法的处理:

那么其中的静态方法Add的CIL代码如下:

//小匹夫注释一下。
.method public hidebysig static int32  Add(int32 a,
                                           int32 b) cil managed
{
  // 代码大小       9 (0x9)
  .maxstack  2
  .locals init ([0] int32 CS$1$0000)   //初始化局部变量列表。因为我们只返回了一个int型。所以这里声明了一个int32类型。索引为0
  IL_0000:  nop
  IL_0001:  ldarg.0     //将索引为 0 的参数加载到计算堆栈上。
  IL_0002:  ldarg.1     //将索引为 1 的参数加载到计算堆栈上。
  IL_0003:  add          //计算
  IL_0004:  stloc.0      //从计算堆栈的顶部弹出当前值并将其存储到索引 0 处的局部变量列表中。
  IL_0005:  br.s       IL_0007
  IL_0007:  ldloc.0     //将索引 0 处的局部变量加载到计算堆栈上。
  IL_0008:  ret           //返回该值
} // end of method Murong::Add

那么我们调用这个静态函数应该就是这样咯。

Murong.Add(1, 2);

对应的CIL代码为:

  IL_0001:  ldc.i4.1 //将整数1压入栈中
  IL_0002:  ldc.i4.2 //将整数2压入栈中
  IL_0003:  call       int32 Murong::Add(int32,
                                         int32)  //调用静态方法

可见CIL直接call了Murong的Add方法,而不需要一个Murong的实例。

实例方法的处理:

Murong类中的实例方法TellName()的CIL代码如下:

.method public hidebysig instance void  TellName(string name) cil managed
{
  // 代码大小       9 (0x9)
  .maxstack  8
  IL_0000:  nop
  IL_0001:  ldarg.1     //看到和静态方法的区别了吗?
  IL_0002:  call       void [mscorlib]System.Console::WriteLine(string)
  IL_0007:  nop
  IL_0008:  ret
} // end of method Murong::TellName

看到和静态方法的区别了吗?对,第一个参数对应的是ldarg.1中的参数1,而不是静态方法中的0。因为此时参数0相当于this,this是不用参与参数传递的。

那么我们再看看调用实例方法的C#代码和对应的CIL代码是如何的。

//C#
Murong murong = new Murong();
murong.TellName("chenjiadong");

CIL:

.locals init ([0] class Murong murong)   //因为C#代码中定义了一个Murong类型的变量,所以局部变量列表的索引0为该类型的引用。
//....
IL_0009:  newobj     instance void Murong::.ctor() //相比上面的静态方法的调用,此处new一个新对象,出现了instance方法。
IL_000e:  stloc.0
IL_000f:  ldloc.0
IL_0010:  ldstr      "chenjiadong" //小匹夫的名字入栈
IL_0015:  callvirt   instance void Murong::TellName(string) //实例方法的调用也有instance

到此,受制于篇幅所限(小匹夫不想写那么多字啊啊啊!)CIL是What的问题大致介绍一下。当然没有再拓展,以后小匹夫可能会再详细写一下这块。

How?

记得语文老师说过,写作文最重要的一点是要首尾呼应。既然咱们开篇就提出了U3D为何能跨平台的问题,那么接近文章的结尾咱们就再来

提问:

Q:上面的Why部分,咱们知道了U3D能跨平台是因为存在着一个能通吃的中间语言CIL,这也是所谓跨平台的前提,但是为啥CIL能通吃各大平台 呢?当然可以说CIL基于堆栈,跟你CPU怎么架构的没啥关系,但是感觉过于理论化、学术化,那还有没有通俗化、工程化的说法呢?

A:原因就是前面小匹夫提到过的,.Net运行时和Mono运行时。也就是说CIL语言其实是运行在虚拟机中的,具体到咱们的U3D也就是mono 的运行时了,换言之mono运行的其实CIL语言,CIL也并非真正的在本地运行,而是在mono运行时中运行的,运行在本地的是被编译后生成的原生代 码。当然看官博的文章,他们似乎也在开发自己的“mono”,也就是被称为脚本的未来的IL2Cpp,这种类似运行时的功能是将IL再编译成c++,再由 c++编译成原生代码,据说效率提升很可观,小匹夫也是蛮期待的。

这里为了“实现跨平台式的演示”,小匹夫用mac给各位做个测试好啦:

从C#到CIL

新建一个cs文件,然后使用mono来运行。这个cs文件内容如下:
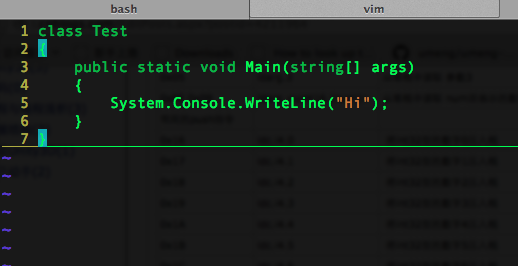
然后咱们直接在命令行中运行这个cs文件试试~
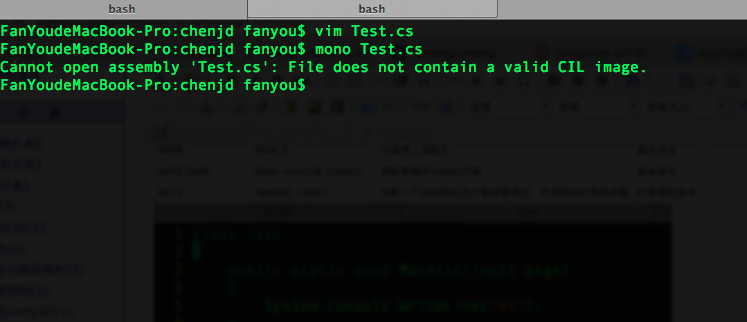
说的很清楚,文件没有包含一个CIL映像。可见mono是不能直接运行cs文件的。假如我们把它编译成CIL呢?那么我们用mono带的mcs来编译小匹夫的Test.cs文件。

mcs Test.cs

生成了什么呢?如图:
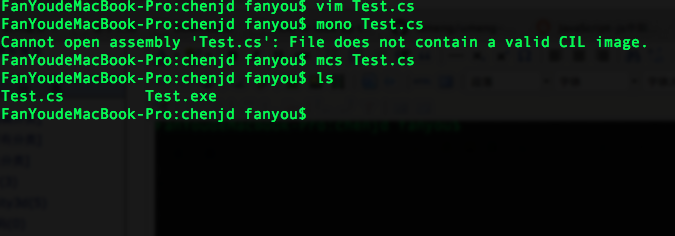
好像没见有叫.IL的文件生成啊?反而好像多了一个.exe文件?可是没听说Mac能运行exe文件呀?可为啥又生成了.exe呢?各位看官可能要 说,小匹夫你是不是拿windows截图P的啊?嘿嘿,小匹夫可不敢。辣么真相其实就是这个exe并不是让Mac来运行的,而是留给mono运行时来运行 的,换言之这个文件的可执行代码形式是CIL的位元码形态。到此,我们完成了从C#到CIL的过程。接下来就让我们运行下刚刚的成果好啦。

mono Test.exe
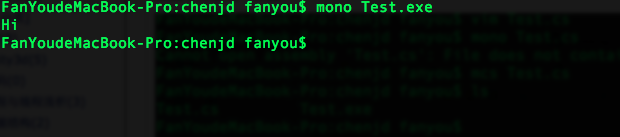
结果是输出了一个大大的“Hi”。这里,就引出了下一个部分。

从CIL到Native Code

这个“HI”可是在小匹夫的MAC终端上出现的呀,那么就证明这个C#写的代码在MAC上运行的还挺“嗨”。

为啥呢?为啥C#写的代码能跑在MAC上呢?这就不得不提从CIL如何到本机原生代码的过程了。Mono提供了两种编译方式,就是我们经常能看到 的:JIT(Just-in-Time compilation,即时编译)和AOT(Ahead-of-Time,提前编译或静态编译)。这两种方式都是将CIL进一步编译成平台的原生代码。 这也是实现跨平台的最后一步。下面就分头介绍一下。

JIT即时编译:

从名字就能看的出来,即时编译,或者称之为动态编译,是在程序执行时才编译代码,解释一条语句执行一条语句,即将一条中间的托管的语句翻译成一条机 器语句,然后执行这条机器语句。但同时也会将编译过的代码进行缓存,而不是每一次都进行编译。所以可以说它是静态编译和解释器的结合体。不过你想想机器既 要处理代码的逻辑,同时还要进行编译的工作,所以其运行时的效率肯定是受到影响的。因此,Mono会有一部分代码通过AOT静态编译,以降低在程序运行时 JIT动态编译在效率上的问题。

不过一向严苛的IOS平台是不允许这种动态的编译方式的,这也是U3D官方无法给出热更新方案的一个原因。而Android平台恰恰相反,Dalvik虚拟机使用的就是JIT方案。

AOT静态编译:

其实Mono的AOT静态编译和JIT并非对立的。AOT同样使用了JIT来进行编译,只不过是被AOT编译的代码在程序运行之前就已经编译好了。当然还有一部分代码会通过JIT来进行动态编译。下面小匹夫就手动操作一下mono,让它进行一次AOT编译。

//在命令行输入
mono --aot Test.exe

结果:
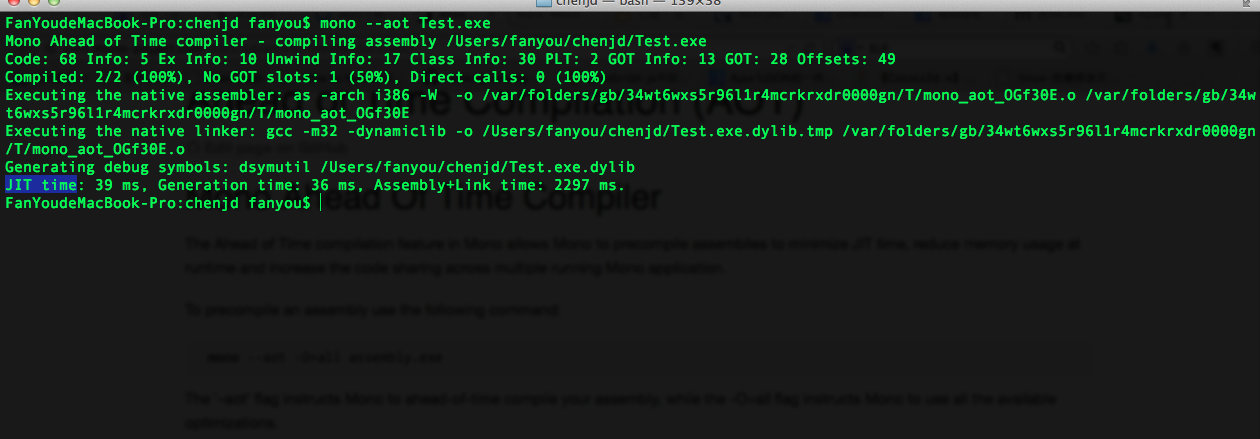
从图中可以看到JIT time: 39 ms,也就是说Mono的AOT模式其实会使用到JIT,同时我们看到了生成了一个适应小匹夫的MAC的动态库Test.exe.dylib,而在Linux生成就是.so(共享库)。

AOT编译出来的库,除了包括我们的代码之外,还有被缓存的元数据信息。所以我们甚至可以只编译元数据信息而不变异代码。例如这样:

//只包含元数据的信息
mono --aot=metadata-only Test.exe
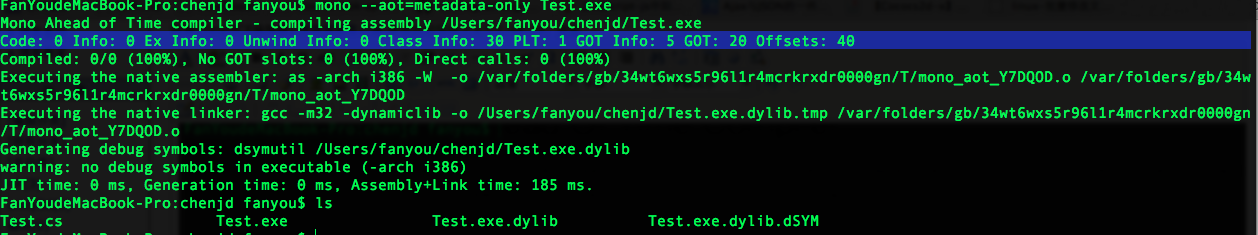
可见代码没有被包括进来。

那么简单总结一下AOT的过程:

  1. 收集要被编译的方法
  2. 使用JIT进行编译
  3. 发射(Emitting)经JIT编译过的代码和其他信息
  4. 直接生成文件或者调用本地汇编器或连接器进行处理之后生成文件。(例如上图中使用了小匹夫本地的gcc)

Full AOT

当然上文也说了,IOS平台是禁止使用JIT的,可看样子Mono的AOT模式仍然会保留一部分代码会在程序运行时动态编译。所以为了破解这个问 题,Mono提供了一个被称为Full AOT的模式。即预先对程序集中的所有CIL代码进行AOT编译生成一个本地代码映像,然后在运行时直接加载这个映像而不再使用JIT引擎。目前由于技术 或实现上的原因在使用Full AOT时有一些限制,不过这里不再多说了。以后也还会更细的分析下AOT。

总结:

好啦,写到现在也已经到了凌晨3:04分了。感觉写的内容也差不多了。那么对本文的主题U3D为何能跨平台以及CIL做个最终的总结陈词:

  1. CIL是CLI标准定义的一种可读性较低的语言。
  2. 以.NET或mono等实现CLI标准的运行环境为目标的语言要先编译成CIL,之后CIL会被编译,并且以位元码的形式存在(源代码—>中间语言的过程)。
  3. 这种位元码运行在虚拟机中(.net mono的运行时)。
  4. 这种位元码可以被进一步编译成不同平台的原生代码(中间语言—>原生代码的过程)。
  5. 面向对象
  6. 基于堆栈

附录:

名称 说明
Add 将两个值相加并将结果推送到计算堆栈上。
Add.Ovf 将两个整数相加,执行溢出检查,并且将结果推送到计算堆栈上。
Add.Ovf.Un 将两个无符号整数值相加,执行溢出检查,并且将结果推送到计算堆栈上。
And 计算两个值的按位“与”并将结果推送到计算堆栈上。
Arglist 返回指向当前方法的参数列表的非托管指针。
Beq 如果两个值相等,则将控制转移到目标指令。
Beq.S 如果两个值相等,则将控制转移到目标指令(短格式)。
Bge 如果第一个值大于或等于第二个值,则将控制转移到目标指令。
Bge.S 如果第一个值大于或等于第二个值,则将控制转移到目标指令(短格式)。
Bge.Un 当比较无符号整数值或不可排序的浮点型值时,如果第一个值大于第二个值,则将控制转移到目标指令。
Bge.Un.S 当比较无符号整数值或不可排序的浮点型值时,如果第一个值大于第二个值,则将控制转移到目标指令(短格式)。
Bgt 如果第一个值大于第二个值,则将控制转移到目标指令。
Bgt.S 如果第一个值大于第二个值,则将控制转移到目标指令(短格式)。
Bgt.Un 当比较无符号整数值或不可排序的浮点型值时,如果第一个值大于第二个值,则将控制转移到目标指令。
Bgt.Un.S 当比较无符号整数值或不可排序的浮点型值时,如果第一个值大于第二个值,则将控制转移到目标指令(短格式)。
Ble 如果第一个值小于或等于第二个值,则将控制转移到目标指令。
Ble.S 如果第一个值小于或等于第二个值,则将控制转移到目标指令(短格式)。
Ble.Un 当比较无符号整数值或不可排序的浮点型值时,如果第一个值小于或等于第二个值,则将控制转移到目标指令。
Ble.Un.S 当比较无符号整数值或不可排序的浮点值时,如果第一个值小于或等于第二个值,则将控制权转移到目标指令(短格式)。
Blt 如果第一个值小于第二个值,则将控制转移到目标指令。
Blt.S 如果第一个值小于第二个值,则将控制转移到目标指令(短格式)。
Blt.Un 当比较无符号整数值或不可排序的浮点型值时,如果第一个值小于第二个值,则将控制转移到目标指令。
Blt.Un.S 当比较无符号整数值或不可排序的浮点型值时,如果第一个值小于第二个值,则将控制转移到目标指令(短格式)。
Bne.Un 当两个无符号整数值或不可排序的浮点型值不相等时,将控制转移到目标指令。
Bne.Un.S 当两个无符号整数值或不可排序的浮点型值不相等时,将控制转移到目标指令(短格式)。
Box 将值类转换为对象引用(O 类型)。
Br 无条件地将控制转移到目标指令。
Br.S 无条件地将控制转移到目标指令(短格式)。
Break 向公共语言结构 (CLI) 发出信号以通知调试器已撞上了一个断点。
Brfalse 如果 value 为 false、空引用(Visual Basic 中的 Nothing)或零,则将控制转移到目标指令。
Brfalse.S 如果 value 为 false、空引用或零,则将控制转移到目标指令。
Brtrue 如果 value 为 true、非空或非零,则将控制转移到目标指令。
Brtrue.S 如果 value 为 true、非空或非零,则将控制转移到目标指令(短格式)。
Call 调用由传递的方法说明符指示的方法。
Calli 通过调用约定描述的参数调用在计算堆栈上指示的方法(作为指向入口点的指针)。
Callvirt 对对象调用后期绑定方法,并且将返回值推送到计算堆栈上。
Castclass 尝试将引用传递的对象转换为指定的类。
Ceq 比较两个值。如果这两个值相等,则将整数值 1 (int32) 推送到计算堆栈上;否则,将 0 (int32) 推送到计算堆栈上。
Cgt 比较两个值。如果第一个值大于第二个值,则将整数值 1 (int32) 推送到计算堆栈上;反之,将 0 (int32) 推送到计算堆栈上。
Cgt.Un 比较两个无符号的或不可排序的值。如果第一个值大于第二个值,则将整数值 1 (int32) 推送到计算堆栈上;反之,将 0 (int32) 推送到计算堆栈上。
Ckfinite 如果值不是有限数,则引发 ArithmeticException。
Clt 比较两个值。如果第一个值小于第二个值,则将整数值 1 (int32) 推送到计算堆栈上;反之,将 0 (int32) 推送到计算堆栈上。
Clt.Un 比较无符号的或不可排序的值 value1 和 value2。如果 value1 小于 value2,则将整数值 1 (int32 ) 推送到计算堆栈上;反之,将 0 ( int32 ) 推送到计算堆栈上。
Constrained 约束要对其进行虚方法调用的类型。
Conv.I 将位于计算堆栈顶部的值转换为 native int。
Conv.I1 将位于计算堆栈顶部的值转换为 int8,然后将其扩展(填充)为 int32。
Conv.I2 将位于计算堆栈顶部的值转换为 int16,然后将其扩展(填充)为 int32。
Conv.I4 将位于计算堆栈顶部的值转换为 int32。
Conv.I8 将位于计算堆栈顶部的值转换为 int64。
Conv.Ovf.I 将位于计算堆栈顶部的有符号值转换为有符号 native int,并在溢出时引发 OverflowException。
Conv.Ovf.I.Un 将位于计算堆栈顶部的无符号值转换为有符号 native int,并在溢出时引发 OverflowException。
Conv.Ovf.I1 将位于计算堆栈顶部的有符号值转换为有符号 int8 并将其扩展为 int32,并在溢出时引发 OverflowException。
Conv.Ovf.I1.Un 将位于计算堆栈顶部的无符号值转换为有符号 int8 并将其扩展为 int32,并在溢出时引发 OverflowException。
Conv.Ovf.I2 将位于计算堆栈顶部的有符号值转换为有符号 int16 并将其扩展为 int32,并在溢出时引发 OverflowException。
Conv.Ovf.I2.Un 将位于计算堆栈顶部的无符号值转换为有符号 int16 并将其扩展为 int32,并在溢出时引发 OverflowException。
Conv.Ovf.I4 将位于计算堆栈顶部的有符号值转换为有符号 int32,并在溢出时引发 OverflowException。
Conv.Ovf.I4.Un 将位于计算堆栈顶部的无符号值转换为有符号 int32,并在溢出时引发 OverflowException。
Conv.Ovf.I8 将位于计算堆栈顶部的有符号值转换为有符号 int64,并在溢出时引发 OverflowException。
Conv.Ovf.I8.Un 将位于计算堆栈顶部的无符号值转换为有符号 int64,并在溢出时引发 OverflowException。
Conv.Ovf.U 将位于计算堆栈顶部的有符号值转换为 unsigned native int,并在溢出时引发 OverflowException。
Conv.Ovf.U.Un 将位于计算堆栈顶部的无符号值转换为 unsigned native int,并在溢出时引发 OverflowException。
Conv.Ovf.U1 将位于计算堆栈顶部的有符号值转换为 unsigned int8 并将其扩展为 int32,并在溢出时引发 OverflowException。
Conv.Ovf.U1.Un 将位于计算堆栈顶部的无符号值转换为 unsigned int8 并将其扩展为 int32,并在溢出时引发 OverflowException。
Conv.Ovf.U2 将位于计算堆栈顶部的有符号值转换为 unsigned int16 并将其扩展为 int32,并在溢出时引发 OverflowException。
Conv.Ovf.U2.Un 将位于计算堆栈顶部的无符号值转换为 unsigned int16 并将其扩展为 int32,并在溢出时引发 OverflowException。
Conv.Ovf.U4 将位于计算堆栈顶部的有符号值转换为 unsigned int32,并在溢出时引发 OverflowException。
Conv.Ovf.U4.Un 将位于计算堆栈顶部的无符号值转换为 unsigned int32,并在溢出时引发 OverflowException。
Conv.Ovf.U8 将位于计算堆栈顶部的有符号值转换为 unsigned int64,并在溢出时引发 OverflowException。
Conv.Ovf.U8.Un 将位于计算堆栈顶部的无符号值转换为 unsigned int64,并在溢出时引发 OverflowException。
Conv.R.Un 将位于计算堆栈顶部的无符号整数值转换为 float32。
Conv.R4 将位于计算堆栈顶部的值转换为 float32。
Conv.R8 将位于计算堆栈顶部的值转换为 float64。
Conv.U 将位于计算堆栈顶部的值转换为 unsigned native int,然后将其扩展为 native int。
Conv.U1 将位于计算堆栈顶部的值转换为 unsigned int8,然后将其扩展为 int32。
Conv.U2 将位于计算堆栈顶部的值转换为 unsigned int16,然后将其扩展为 int32。
Conv.U4 将位于计算堆栈顶部的值转换为 unsigned int32,然后将其扩展为 int32。
Conv.U8 将位于计算堆栈顶部的值转换为 unsigned int64,然后将其扩展为 int64。
Cpblk 将指定数目的字节从源地址复制到目标地址。
Cpobj 将位于对象(&、* 或 native int 类型)地址的值类型复制到目标对象(&、* 或 native int 类型)的地址。
Div 将两个值相除并将结果作为浮点(F 类型)或商(int32 类型)推送到计算堆栈上。
Div.Un 两个无符号整数值相除并将结果 ( int32 ) 推送到计算堆栈上。
Dup 复制计算堆栈上当前最顶端的值,然后将副本推送到计算堆栈上。
Endfilter 将控制从异常的 filter 子句转移回公共语言结构 (CLI) 异常处理程序。
Endfinally 将控制从异常块的 fault 或 finally 子句转移回公共语言结构 (CLI) 异常处理程序。
Initblk 将位于特定地址的内存的指定块初始化为给定大小和初始值。
Initobj 将位于指定地址的值类型的每个字段初始化为空引用或适当的基元类型的 0。
Isinst 测试对象引用(O 类型)是否为特定类的实例。
Jmp 退出当前方法并跳至指定方法。
Ldarg 将参数(由指定索引值引用)加载到堆栈上。
Ldarg.0 将索引为 0 的参数加载到计算堆栈上。
Ldarg.1 将索引为 1 的参数加载到计算堆栈上。
Ldarg.2 将索引为 2 的参数加载到计算堆栈上。
Ldarg.3 将索引为 3 的参数加载到计算堆栈上。
Ldarg.S 将参数(由指定的短格式索引引用)加载到计算堆栈上。
Ldarga 将参数地址加载到计算堆栈上。
Ldarga.S 以短格式将参数地址加载到计算堆栈上。
Ldc.I4 将所提供的 int32 类型的值作为 int32 推送到计算堆栈上。
Ldc.I4.0 将整数值 0 作为 int32 推送到计算堆栈上。
Ldc.I4.1 将整数值 1 作为 int32 推送到计算堆栈上。
Ldc.I4.2 将整数值 2 作为 int32 推送到计算堆栈上。
Ldc.I4.3 将整数值 3 作为 int32 推送到计算堆栈上。
Ldc.I4.4 将整数值 4 作为 int32 推送到计算堆栈上。
Ldc.I4.5 将整数值 5 作为 int32 推送到计算堆栈上。
Ldc.I4.6 将整数值 6 作为 int32 推送到计算堆栈上。
Ldc.I4.7 将整数值 7 作为 int32 推送到计算堆栈上。
Ldc.I4.8 将整数值 8 作为 int32 推送到计算堆栈上。
Ldc.I4.M1 将整数值 -1 作为 int32 推送到计算堆栈上。
Ldc.I4.S 将提供的 int8 值作为 int32 推送到计算堆栈上(短格式)。
Ldc.I8 将所提供的 int64 类型的值作为 int64 推送到计算堆栈上。
Ldc.R4 将所提供的 float32 类型的值作为 F (float) 类型推送到计算堆栈上。
Ldc.R8 将所提供的 float64 类型的值作为 F (float) 类型推送到计算堆栈上。
Ldelem 按照指令中指定的类型,将指定数组索引中的元素加载到计算堆栈的顶部。
Ldelem.I 将位于指定数组索引处的 native int 类型的元素作为 native int 加载到计算堆栈的顶部。
Ldelem.I1 将位于指定数组索引处的 int8 类型的元素作为 int32 加载到计算堆栈的顶部。
Ldelem.I2 将位于指定数组索引处的 int16 类型的元素作为 int32 加载到计算堆栈的顶部。
Ldelem.I4 将位于指定数组索引处的 int32 类型的元素作为 int32 加载到计算堆栈的顶部。
Ldelem.I8 将位于指定数组索引处的 int64 类型的元素作为 int64 加载到计算堆栈的顶部。
Ldelem.R4 将位于指定数组索引处的 float32 类型的元素作为 F 类型(浮点型)加载到计算堆栈的顶部。
Ldelem.R8 将位于指定数组索引处的 float64 类型的元素作为 F 类型(浮点型)加载到计算堆栈的顶部。
Ldelem.Ref 将位于指定数组索引处的包含对象引用的元素作为 O 类型(对象引用)加载到计算堆栈的顶部。
Ldelem.U1 将位于指定数组索引处的 unsigned int8 类型的元素作为 int32 加载到计算堆栈的顶部。
Ldelem.U2 将位于指定数组索引处的 unsigned int16 类型的元素作为 int32 加载到计算堆栈的顶部。
Ldelem.U4 将位于指定数组索引处的 unsigned int32 类型的元素作为 int32 加载到计算堆栈的顶部。
Ldelema 将位于指定数组索引的数组元素的地址作为 & 类型(托管指针)加载到计算堆栈的顶部。
Ldfld 查找对象中其引用当前位于计算堆栈的字段的值。
Ldflda 查找对象中其引用当前位于计算堆栈的字段的地址。
Ldftn 将指向实现特定方法的本机代码的非托管指针(native int 类型)推送到计算堆栈上。
Ldind.I 将 native int 类型的值作为 native int 间接加载到计算堆栈上。
Ldind.I1 将 int8 类型的值作为 int32 间接加载到计算堆栈上。
Ldind.I2 将 int16 类型的值作为 int32 间接加载到计算堆栈上。
Ldind.I4 将 int32 类型的值作为 int32 间接加载到计算堆栈上。
Ldind.I8 将 int64 类型的值作为 int64 间接加载到计算堆栈上。
Ldind.R4 将 float32 类型的值作为 F (float) 类型间接加载到计算堆栈上。
Ldind.R8 将 float64 类型的值作为 F (float) 类型间接加载到计算堆栈上。
Ldind.Ref 将对象引用作为 O(对象引用)类型间接加载到计算堆栈上。
Ldind.U1 将 unsigned int8 类型的值作为 int32 间接加载到计算堆栈上。
Ldind.U2 将 unsigned int16 类型的值作为 int32 间接加载到计算堆栈上。
Ldind.U4 将 unsigned int32 类型的值作为 int32 间接加载到计算堆栈上。
Ldlen 将从零开始的、一维数组的元素的数目推送到计算堆栈上。
Ldloc 将指定索引处的局部变量加载到计算堆栈上。
Ldloc.0 将索引 0 处的局部变量加载到计算堆栈上。
Ldloc.1 将索引 1 处的局部变量加载到计算堆栈上。
Ldloc.2 将索引 2 处的局部变量加载到计算堆栈上。
Ldloc.3 将索引 3 处的局部变量加载到计算堆栈上。
Ldloc.S 将特定索引处的局部变量加载到计算堆栈上(短格式)。
Ldloca 将位于特定索引处的局部变量的地址加载到计算堆栈上。
Ldloca.S 将位于特定索引处的局部变量的地址加载到计算堆栈上(短格式)。
Ldnull 将空引用(O 类型)推送到计算堆栈上。
Ldobj 将地址指向的值类型对象复制到计算堆栈的顶部。
Ldsfld 将静态字段的值推送到计算堆栈上。
Ldsflda 将静态字段的地址推送到计算堆栈上。
Ldstr 推送对元数据中存储的字符串的新对象引用。
Ldtoken 将元数据标记转换为其运行时表示形式,并将其推送到计算堆栈上。
Ldvirtftn 将指向实现与指定对象关联的特定虚方法的本机代码的非托管指针(native int 类型)推送到计算堆栈上。
Leave 退出受保护的代码区域,无条件将控制转移到特定目标指令。
Leave.S 退出受保护的代码区域,无条件将控制转移到目标指令(缩写形式)。
Localloc 从本地动态内存池分配特定数目的字节并将第一个分配的字节的地址(瞬态指针,* 类型)推送到计算堆栈上。
Mkrefany 将对特定类型实例的类型化引用推送到计算堆栈上。
Mul 将两个值相乘并将结果推送到计算堆栈上。
Mul.Ovf 将两个整数值相乘,执行溢出检查,并将结果推送到计算堆栈上。
Mul.Ovf.Un 将两个无符号整数值相乘,执行溢出检查,并将结果推送到计算堆栈上。
Neg 对一个值执行求反并将结果推送到计算堆栈上。
Newarr 将对新的从零开始的一维数组(其元素属于特定类型)的对象引用推送到计算堆栈上。
Newobj 创建一个值类型的新对象或新实例,并将对象引用(O 类型)推送到计算堆栈上。
Nop 如果修补操作码,则填充空间。尽管可能消耗处理周期,但未执行任何有意义的操作。
Not 计算堆栈顶部整数值的按位求补并将结果作为相同的类型推送到计算堆栈上。
Or 计算位于堆栈顶部的两个整数值的按位求补并将结果推送到计算堆栈上。
Pop 移除当前位于计算堆栈顶部的值。
Prefix1 基础结构。此指令为保留指令。
Prefix2 基础结构。此指令为保留指令。
Prefix3 基础结构。此指令为保留指令。
Prefix4 基础结构。此指令为保留指令。
Prefix5 基础结构。此指令为保留指令。
Prefix6 基础结构。此指令为保留指令。
Prefix7 基础结构。此指令为保留指令。
Prefixref 基础结构。此指令为保留指令。
Readonly 指定后面的数组地址操作在运行时不执行类型检查,并且返回可变性受限的托管指针。
Refanytype 检索嵌入在类型化引用内的类型标记。
Refanyval 检索嵌入在类型化引用内的地址(& 类型)。
Rem 将两个值相除并将余数推送到计算堆栈上。
Rem.Un 将两个无符号值相除并将余数推送到计算堆栈上。
Ret 从当前方法返回,并将返回值(如果存在)从调用方的计算堆栈推送到被调用方的计算堆栈上。
Rethrow 再次引发当前异常。
Shl 将整数值左移(用零填充)指定的位数,并将结果推送到计算堆栈上。
Shr 将整数值右移(保留符号)指定的位数,并将结果推送到计算堆栈上。
Shr.Un 将无符号整数值右移(用零填充)指定的位数,并将结果推送到计算堆栈上。
Sizeof 将提供的值类型的大小(以字节为单位)推送到计算堆栈上。
Starg 将位于计算堆栈顶部的值存储到位于指定索引的参数槽中。
Starg.S 将位于计算堆栈顶部的值存储在参数槽中的指定索引处(短格式)。
Stelem 用计算堆栈中的值替换给定索引处的数组元素,其类型在指令中指定。
Stelem.I 用计算堆栈上的 native int 值替换给定索引处的数组元素。
Stelem.I1 用计算堆栈上的 int8 值替换给定索引处的数组元素。
Stelem.I2 用计算堆栈上的 int16 值替换给定索引处的数组元素。
Stelem.I4 用计算堆栈上的 int32 值替换给定索引处的数组元素。
Stelem.I8 用计算堆栈上的 int64 值替换给定索引处的数组元素。
Stelem.R4 用计算堆栈上的 float32 值替换给定索引处的数组元素。
Stelem.R8 用计算堆栈上的 float64 值替换给定索引处的数组元素。
Stelem.Ref 用计算堆栈上的对象 ref 值(O 类型)替换给定索引处的数组元素。
Stfld 用新值替换在对象引用或指针的字段中存储的值。
Stind.I 在所提供的地址存储 native int 类型的值。
Stind.I1 在所提供的地址存储 int8 类型的值。
Stind.I2 在所提供的地址存储 int16 类型的值。
Stind.I4 在所提供的地址存储 int32 类型的值。
Stind.I8 在所提供的地址存储 int64 类型的值。
Stind.R4 在所提供的地址存储 float32 类型的值。
Stind.R8 在所提供的地址存储 float64 类型的值。
Stind.Ref 存储所提供地址处的对象引用值。
Stloc 从计算堆栈的顶部弹出当前值并将其存储到指定索引处的局部变量列表中。
Stloc.0 从计算堆栈的顶部弹出当前值并将其存储到索引 0 处的局部变量列表中。
Stloc.1 从计算堆栈的顶部弹出当前值并将其存储到索引 1 处的局部变量列表中。
Stloc.2 从计算堆栈的顶部弹出当前值并将其存储到索引 2 处的局部变量列表中。
Stloc.3 从计算堆栈的顶部弹出当前值并将其存储到索引 3 处的局部变量列表中。
Stloc.S 从计算堆栈的顶部弹出当前值并将其存储在局部变量列表中的 index 处(短格式)。
Stobj 将指定类型的值从计算堆栈复制到所提供的内存地址中。
Stsfld 用来自计算堆栈的值替换静态字段的值。
Sub 从其他值中减去一个值并将结果推送到计算堆栈上。
Sub.Ovf 从另一值中减去一个整数值,执行溢出检查,并且将结果推送到计算堆栈上。
Sub.Ovf.Un 从另一值中减去一个无符号整数值,执行溢出检查,并且将结果推送到计算堆栈上。
Switch 实现跳转表。
Tailcall 执行后缀的方法调用指令,以便在执行实际调用指令前移除当前方法的堆栈帧。
Throw 引发当前位于计算堆栈上的异常对象。
Unaligned 指示当前位于计算堆栈上的地址可能没有与紧接的 ldind、stind、ldfld、stfld、ldobj、stobj、initblk 或 cpblk 指令的自然大小对齐。
Unbox 将值类型的已装箱的表示形式转换为其未装箱的形式。
Unbox.Any 将指令中指定类型的已装箱的表示形式转换成未装箱形式。
Volatile 指定当前位于计算堆栈顶部的地址可以是易失的,并且读取该位置的结果不能被缓存,或者对该地址的多个存储区不能被取消。
Xor 计算位于计算堆栈顶部的两个值的按位异或,并且将结果推送到计算堆栈上。

QuartZ中的Cron表达式

一个cron 表达式是由6或者7个以空格分隔的字段组成。字段能够包含任何允许值,伴随着特殊字符不同组合。这些字段如下所示:

字段名称 是否一定需要 允许的值 允许的特殊字符串
Seconds YES 0-59 , – * /
Minutes YES 0-59 , – * /
Hours YES 0-23 , – * /
Day of month YES 1-31 , – * ? / L W
Month YES 1-12 or JAN-DEC , – * /
Day of week YES 1-7 or SUN-SAT , – * ? / L #
Year NO empty, 1970-2099 , – * /

可见,一个简单的cron表达式可以如此* * * * ? *表达或者更复杂些,像这样

0/5 14,18,3-39,52 * ? JAN,MAR,SEPMON-FRI 2002-2010

特殊字符串说明

  • * (“所有的值”) – 意味着所有值。
  • ? (“无特殊值”) – 当你需要指定两个字段中的一个时,这个字符很有用。比如,如果我想在一个月中的特别的一天(可以是第10号之类的)触发我的触发器,但是我并不关心它是哪个星期执行。这样的话,可以在月份字段上设置0,星期字段上设置问号(?)。
  • –(“指定区间”)-  用来指定区间。比如,“10-12”在小时字段中,这意味着“10点、11点和12点”
  • ,(“定额外的值”)- 用来指定额外的值。比如,在星期字段中,“MON,WED,FRI”表示“星期一,星期三,星期五”。
  • / (“递增”)-用来指定递增量。比如,在秒字段上,“0/15”表示“0秒、15秒、30秒和45秒”。
  • L (“最后”) –在两个字段上,它们有不同的含义。比如,在天数字段上,“L”值意味着“一个月的最后一天”–平年中2月份的28号,一月的31号等。如果使用在星期 字段中,它简单地意味着“7”或者“星期六”。当使用“L”时,那是很重要的,不去指定列表或者区间,因为你将获得令人困惑的结果。
  • W (“星期”) – 使用来指定星期中最靠近给予的天。例如,我在天数字段上指定了“15W”,这就意味着“这个月离15号最近的某个星期”。如果15号是星期天,它将在周六 的14号触发。如果15好是一个星期二,那么他将在15号的星期二触发。在天字段上,“W”不会跳跃过月份来触发执行。在天数字段上,“L”和“W”能够 结合使用,表示的意思是:“月份的最后一个星期”
  • # (“天数”) –用来指定一个月的某一天。比如,在星期字段上,“6#3”表示“每月的第三个星期五”(6表示星期五,#3表示这个月的第三个)。如果像“#3”指定的话,它将不会触发。

合法的字符串、月份的名字和星期的字母表示,这些都不是大小写敏感的。

下面有一个完全的例子:

0 0 12 * * ? Fire at 12pm (noon) every day
0 15 10 ? * * Fire at 10:15am every day
0 15 10 * * ? Fire at 10:15am every day
0 15 10 * * ? * Fire at 10:15am every day
0 15 10 * * ? 2005 Fire at 10:15am every day during the year 2005
0 * 14 * * ? Fire every minute starting at 2pm and ending at 2:59pm, every day
0 0/5 14 * * ? Fire every 5 minutes starting at 2pm and ending at 2:55pm, every day
0 0/5 14,18 * * ? Fire every 5 minutes starting at 2pm and ending at 2:55pm, AND fire every 5 minutes starting at 6pm and ending at 6:55pm, every day
0 0-5 14 * * ? Fire every minute starting at 2pm and ending at 2:05pm, every day
0 10,44 14 ? 3 WED Fire at 2:10pm and at 2:44pm every Wednesday in the month of March.
0 15 10 ? * MON-FRI Fire at 10:15am every Monday, Tuesday, Wednesday, Thursday and Friday
0 15 10 15 * ? Fire at 10:15am on the 15th day of every month
0 15 10 L * ? Fire at 10:15am on the last day of every month
0 15 10 ? * 6L Fire at 10:15am on the last Friday of every month
0 15 10 ? * 6L 2002-2005 Fire at 10:15am on every last friday of every month during the years 2002, 2003, 2004 and 2005
0 15 10 ? * 6#3 Fire at 10:15am on the third Friday of every month
0 0 12 1/5 * ? Fire at 12pm (noon) every 5 days every month, starting on the first day of the month.
0 11 11 11 11 ? Fire every November 11th at 11:11am.


常用的SQL优化技巧

常见的字段类型选择

•字符类型建议采用varchar/nvarchar数据类型
•金额货币建议采用money数据类型
•科学计数建议采用numeric数据类型
•自增长标识建议采用bigint数据类型   (数据量一大,用int类型就装不下,那以后改造就麻烦了)
•时间类型建议采用为datetime数据类型
•禁止使用text、ntext、image老的数据类型
•禁止使用xml数据类型、varchar(max)、nvarchar(max)

约束与索引

每张表必须有主键

•每张表必须有主键,用于强制实体完整性
•单表只能有一个主键(不允许为空及重复数据)
•尽量使用单字段主键

不允许使用外键

•外键增加了表结构变更及数据迁移的复杂性
•外键对插入,更新的性能有影响,需要检查主外键约束
•数据完整性由程序控制

索引设计准则

•应该对 WHERE 子句中经常使用的列创建索引
•应该对经常用于连接表的列创建索引
•应该对 ORDER BY 子句中经常使用的列创建索引
•不应该对小型的表(仅使用几个页的表)创建索引,这是因为完全表扫描操作可能比使用索引执行的查询快
•单表索引数不超过6个
•不要给选择性低的字段建单列索引
•充分利用唯一约束
•索引包含的字段不超过5个(包括include列)

不要给选择性低的字段创建单列索引

•SQL SERVER对索引字段的选择性有要求,如果选择性太低SQL SERVER会放弃使用•
•不适合创建索引的字段:性别、0/1、TRUE/FALSE
•适合创建索引的字段:ORDERID、UID等

充分利用唯一索引

唯一索引给SQL Server提供了确保某一列绝对没有重复值的信息,当查询分析器通过唯一索引查找到一条记录则会立刻退出,不会继续查找索引

•表索引数不超过6个, 表索引数不超过6个(这个规则只是携程DBA经过试验之后制定的。。。)
•索引加快了查询速度,但是却会影响写入性能
•一个表的索引应该结合这个表相关的所有SQL综合创建,尽量合并
•组合索引的原则是,过滤性越好的字段越靠前
•索引过多不仅会增加编译时间,也会影响数据库选择最佳执行计划

SQL查询

•禁止在数据库做复杂运算
•禁止使用SELECT *
•禁止在索引列上使用函数或计算
•禁止使用游标
•禁止使用触发器
•禁止在查询里指定索引
•变量/参数/关联字段类型必须与字段类型一致
•参数化查询
•限制JOIN个数
•限制SQL语句长度及IN子句个数
•尽量避免大事务操作
•关闭影响的行计数信息返回
•除非必要SELECT语句都必须加上NOLOCK
•使用UNION ALL替换UNION
•查询大量数据使用分页或TOP
•递归查询层级限制
•NOT EXISTS替代NOT IN
•临时表与表变量
•使用本地变量选择中庸执行计划
•尽量避免使用OR运算符
•增加事务异常处理机制
•输出列使用二段式命名格式

禁止在数据库做复杂运算

•XML解析
•字符串相似性比较
•字符串搜索(Charindex)
•复杂运算在程序端完成

禁止使用SELECT *

•减少内存消耗和网络带宽
•给查询优化器有机会从索引读取所需要的列
•表结构变化时容易引起查询出错

•禁止在索引列上使用函数或计算

禁止在索引列上使用函数或计算

假设在字段Col1上建有一个索引,则下列场景将可以使用到索引:

[Col1]=3.14

[Col1]>100

[Col1] BETWEEN 0 AND 99

[Col1] LIKE ‘abc%’

[Col1] IN(2,3,5,7)

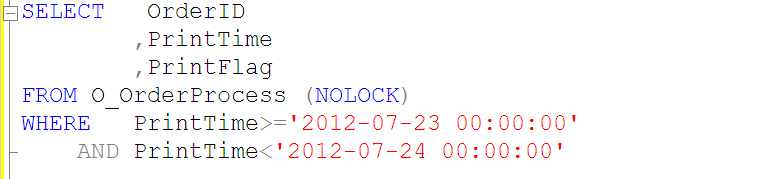
像上面这样的查询,将无法用到O_OrderProcess表上的PrintTime索引

LIKE查询的索引问题

•[Col1] like “abc%”  –index seek  这个就用到了索引查询
•[Col1] like “%abc%”  –index scan  而这个就并未用到索引查询
•[Col1] like “%abc”  –index scan 这个也并未用到索引查询
我想从上而三个例子中,大家应该明白,最好不要在LIKE条件前面用模糊匹配,否则就用不到索引查询。

禁止使用游标

•关系数据库适合集合操作,也就是对由WHERE子句和选择列确定的结果集作集合操作,游标是提供的一个非集合操作的途径。一般情况下,游标实现的功能往往相当于客户端的一个循环实现的功能。
•游标是把结果集放在服务器内存,并通过循环一条一条处理记录,对数据库资源(特别是内存和锁资源)的消耗是非常大的。
(再加上游标真心比较复杂,挺不好用的,尽量少用吧)

禁止使用触发器

•触发器对应用不透明(应用层面都不知道会什么时候触发触发器,发生也也不知道,感觉莫名其秒)

禁止在查询里指定索引

With(index=XXX)( 在查询里我们指定索引一般都用With(index=XXX) )

•随着数据的变化查询语句指定的索引性能可能并不最佳
•索引对应用应是透明的,如指定的索引被删除将会导致查询报错,不利于排障
•新建的索引无法被应用立即使用,必须通过发布代码才能生效

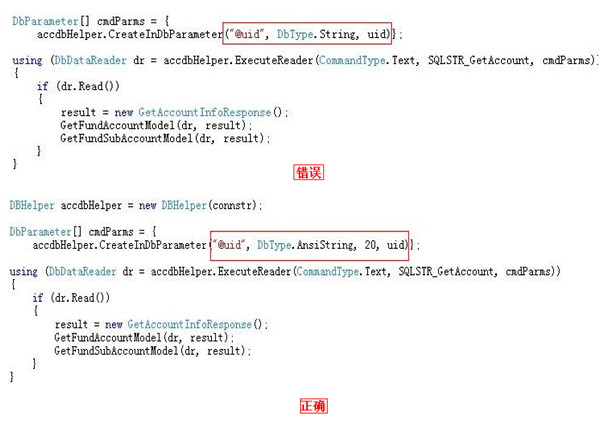
变量/参数/关联字段类型必须与字段类型一致(这是我之前不太关注的)

避免类型转换额外消耗的CPU,引起的大表scan尤为严重

看了上面这两个图,我想我不用解释说明,大家都应该已经清楚了吧。

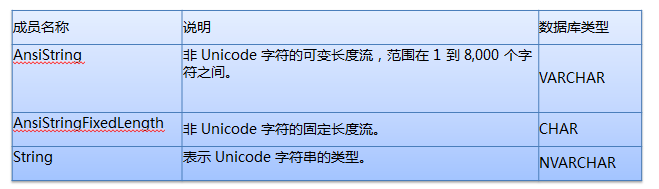
如果数据库字段类型为VARCHAR,在应用里面最好类型指定为AnsiString并明确指定其长度

如果数据库字段类型为CHAR,在应用里面最好类型指定为AnsiStringFixedLength并明确指定其长度

如果数据库字段类型为NVARCHAR,在应用里面最好类型指定为String并明确指定其长度

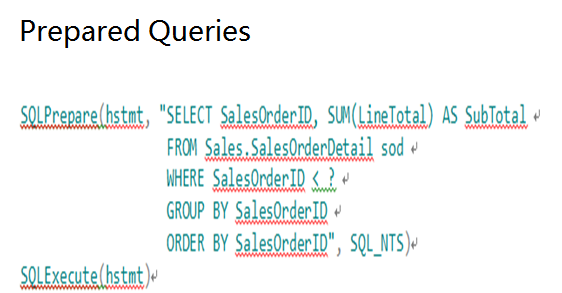
参数化查询

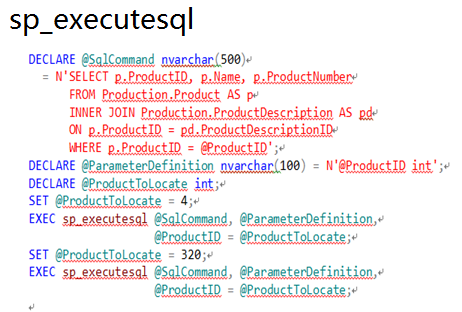
以下方式可以对查询SQL进行参数化:

•sp_executesql
•Prepared Queries
•Stored procedures
用图来说明一下,哈哈。

限制JOIN个数

•单个SQL语句的表JOIN个数不能超过5个
•过多的JOIN个数会导致查询分析器走错执行计划
•过多JOIN在编译执行计划时消耗很大

限制IN子句中条件个数

•在 IN 子句中包括数量非常多的值(数以千计)可能会消耗资源并返回错误 8623 或 8632,要求IN子句中条件个数限制在100个以内

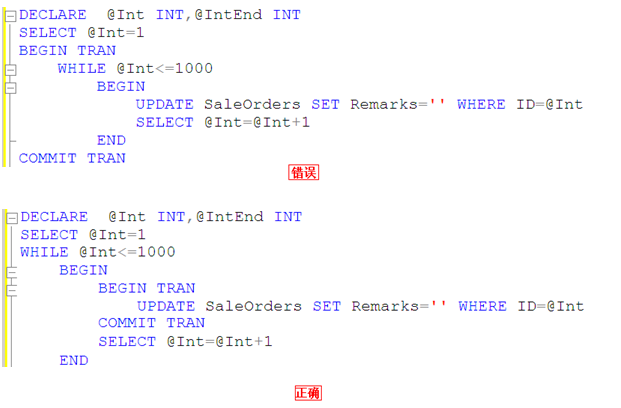
尽量避免大事务操作

•只在数据需要更新时开始事务,减少资源锁持有时间
•增加事务异常捕获预处理机制
•禁止使用数据库上的分布式事务
用图来说明一下
也就是说我们不应该在1000行数据都更新完成之后再commit tran,你想想你在更新这一千行数据的时候是不是独占资源导致其它事务无法处理。

关闭影响的行计数信息返回

在SQL语句中显示设置Set Nocount On,取消影响的行计数信息返回,减少网络流量

除非必要,尽量让所有的select语句都必须加上NOLOCK

指定允许脏读。不发布共享锁来阻止其他事务修改当前事务读取的数据,其他事务设  置的排他锁不会阻碍当前事务读取锁定数据。允许脏读可能产生较多的并发操作,但其代价是读取以后会被其他事务回滚的数据修改。这可能会使您的事务出错,向 用户显示从未提交过的数据,或者导致用户两次看到记录(或根本看不到记录)

使用UNION ALL替换UNION

UNION会对SQL结果集去重排序,增加CPU、内存等消耗

查询大量数据使用分页或TOP

合理限制记录返回数,避免IO、网络带宽出现瓶颈

递归查询层次限制

使用 MAXRECURSION 来防止不合理的递归 CTE 进入无限循环

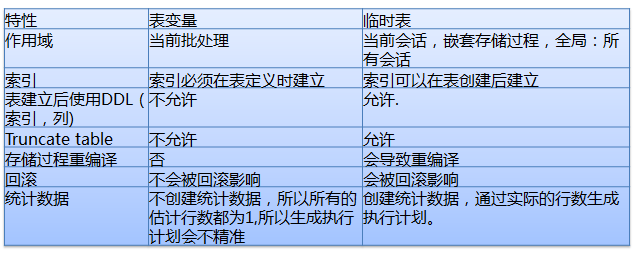
临时表与表变量

使用本地变量选择中庸执行计划

在存储过程或查询中,访问了一张数据分布很不平均的表格,这样往往会让存储过程或查询使用了次优甚至于较差的执行计划上,造成High CPU及大量IO Read等问题,使用本地变量防止走错执行计划。

采用本地变量的方式,SQL在编译的时候是不知道这个本地变量的值,这时候SQL会根据表格里数据的一般分布,“猜测”一个返回值。不管用户在调用存储过程或语句的时候代入的变量值是多少,生成的计划都是一样的。这样的计划一般会比较中庸一些,不一定是最优的计划,但一般也不会是最差的计划

如果查询中本地变量使用了不等式运算符,查询分析器使用了一个简单的 30% 的算式来预估
Estimated Rows =(Total Rows * 30)/100
如果查询中本地变量使用了等式运算符,则查询分析器使用:精确度 * 表记录总数来预估
Estimated Rows = Density * Total Rows

尽量避免使用OR运算符

对于OR运算符,通常会使用全表扫描,考虑分解成多个查询用UNION/UNION ALL来实现,这里要确认查询能走到索引并返回较少的结果集

增加事务异常处理机制

应用程序做好意外处理,及时做Rollback。
设置连接属性 “set xact_abort on”

输出列使用二段式命名格式

二段式命名格式:表名.字段名

有JOIN关系的TSQL,字段必须指明字段是属于哪个表的,否则未来表结构变更后,有可能发生Ambiguous column name的程序兼容错误

架构设计

•读写分离
•schema解耦
•数据生命周期

读写分离

•设计之初就考虑读写分离,哪怕读写同一个库,有利于快速扩容
•按照读特征把读分为实时读和可延迟读分别对应到写库和读库
•读写分离应该考虑在读不可用情况下自动切换到写端

Schema解耦

禁止跨库JOIN

数据生命周期

根据数据的使用频繁度,对大表定期分库归档

主库/归档库物理分离

日志类型的表应分区或分表

对于大的表格要进行分区,分区操作将表和索引分在多个分区,通过分区切换能够快速实现新旧分区替换,加快数据清理速度,大幅减少IO资源消耗

频繁写入的表,需要分区或分表

自增长与Latch Lock

闩锁是sql Server自己内部申请和控制,用户没有办法来干预,用来保证内存里面数据结构的一致性,锁级别是页级锁

C# 中发送和接收MSMQ的一个示例

Ok, 直接上代码:

using System;
using System.Collections.Generic;
using System.ComponentModel;
using System.Data;
using System.Drawing;
using System.Linq;
using System.Text;
using System.Threading;
using System.Windows.Forms;

namespace WindowsFormsApplication3
{
    public class Form1 : Form
    {
        /// <summary>
        /// Required designer variable.
        /// </summary>
        private System.ComponentModel.IContainer components = null;

        /// <summary>
        /// Clean up any resources being used.
        /// </summary>
        /// <param name="disposing">true if managed resources should be disposed; otherwise, false.</param>
        protected override void Dispose(bool disposing)
        {
            if (disposing && (components != null))
            {
                components.Dispose();
            }
            base.Dispose(disposing);
        }

        #region Windows Form Designer generated code

        /// <summary>
        /// Required method for Designer support - do not modify
        /// the contents of this method with the code editor.
        /// </summary>
        private void InitializeComponent()
        {
            this.button1 = new System.Windows.Forms.Button();
            this.button2 = new System.Windows.Forms.Button();
            this.label1 = new System.Windows.Forms.Label();
            this.button3 = new System.Windows.Forms.Button();
            this.label2 = new System.Windows.Forms.Label();
            this.SuspendLayout();
            // 
            // button1
            // 
            this.button1.Location = new System.Drawing.Point(198, 52);
            this.button1.Name = "button1";
            this.button1.Size = new System.Drawing.Size(143, 23);
            this.button1.TabIndex = 0;
            this.button1.Text = "Send Message";
            this.button1.UseVisualStyleBackColor = true;
            this.button1.Click += new System.EventHandler(this.button1_Click);
            // 
            // button2
            // 
            this.button2.Location = new System.Drawing.Point(12, 52);
            this.button2.Name = "button2";
            this.button2.Size = new System.Drawing.Size(157, 23);
            this.button2.TabIndex = 1;
            this.button2.Text = "Received Message";
            this.button2.UseVisualStyleBackColor = true;
            this.button2.Click += new System.EventHandler(this.button2_Click);
            // 
            // label1
            // 
            this.label1.AutoSize = true;
            this.label1.Location = new System.Drawing.Point(151, 94);
            this.label1.Name = "label1";
            this.label1.Size = new System.Drawing.Size(31, 13);
            this.label1.TabIndex = 2;
            this.label1.Text = "none";
            // 
            // button3
            // 
            this.button3.Location = new System.Drawing.Point(366, 52);
            this.button3.Name = "button3";
            this.button3.Size = new System.Drawing.Size(157, 23);
            this.button3.TabIndex = 3;
            this.button3.Text = "Stop Receiveing";
            this.button3.UseVisualStyleBackColor = true;
            // 
            // label2
            // 
            this.label2.AutoSize = true;
            this.label2.Location = new System.Drawing.Point(12, 94);
            this.label2.Name = "label2";
            this.label2.Size = new System.Drawing.Size(133, 13);
            this.label2.TabIndex = 4;
            this.label2.Text = "Received a new message:";
            // 
            // Form1
            // 
            this.AutoScaleDimensions = new System.Drawing.SizeF(6F, 13F);
            this.AutoScaleMode = System.Windows.Forms.AutoScaleMode.Font;
            this.ClientSize = new System.Drawing.Size(565, 146);
            this.Controls.Add(this.label2);
            this.Controls.Add(this.button3);
            this.Controls.Add(this.label1);
            this.Controls.Add(this.button2);
            this.Controls.Add(this.button1);
            this.Name = "Form1";
            this.Text = "Form1";
            this.ResumeLayout(false);
            this.PerformLayout();

        }

        #endregion

        private System.Windows.Forms.Button button1;
        private System.Windows.Forms.Button button2;
        private System.Windows.Forms.Label label1;
        private System.Windows.Forms.Button button3;
        private System.Windows.Forms.Label label2;

        public Form1()
        {
            InitializeComponent();
        }

        private void button1_Click(object sender, EventArgs e)
        {
            System.Messaging.MessageQueue mq;

            // 如果不存在google这个队列, 那么创建这个队列
            if (System.Messaging.MessageQueue.Exists(".\\google"))
            {
                mq = new System.Messaging.MessageQueue(".\\google");
            }
            else
                mq = System.Messaging.MessageQueue.Create(".\\google");
            mq.Purge();// 将队列清空
            // 向队列中发送一条消息, 1个随机的数字, 并使用XML序列化进行传输
            mq.Send(new System.Messaging.Message(new Random().NextDouble(), new System.Messaging.XmlMessageFormatter()));

        }


        private void Fn()
        {
            var mq = new System.Messaging.MessageQueue(".\\google")
            {
                Formatter = new System.Messaging.XmlMessageFormatter(new[] { typeof(double) })
            };
            while (true)
            {
                var message = mq.Receive();
                if (null != message)
                    Invoke(Convert.ToString(message.Body));
                Thread.Sleep(100);
            }

        }

        private delegate void Do(string str);


        private void Set(string str)
        {
            label1.Text = str;
        }

        // 默认情况下, Window form是不允许被非创建它的线程进行访问的, 所以要通过delegate进行安全调用
        // 可以通过设置 Control.CheckForIllegalCrossThreadCalls = false; 来取消跨线程调用的限制
        private void Invoke(string str)
        {
            var foo = new Do(Set);
            // 可以看到: 是label1 这个控件去调用foo, 是种主动行为. 这样就不会引用跨线程调用异常
            label1.Invoke(foo, str);
        }

        private void button2_Click(object sender, EventArgs e)
        {
            // 创建一个新的线程去接收队列中的消息
            var ts = new ThreadStart(Fn);
            var th = new Thread(ts);
            MessageBox.Show(@"Start Receiving");
            th.Start();
        }
    }
}

有几个点可以说一下:

1. 首先得有队列, 在没有队列的情况下, new System.Messaging.MessageQueue(“.\\google”) 是会有异常的, 所以得先判断和创建队列通道:

            System.Messaging.MessageQueue mq;

            // 如果不存在google这个队列, 那么创建这个队列
            if (System.Messaging.MessageQueue.Exists(".\\google"))
            {
                mq = new System.Messaging.MessageQueue(".\\google");
            }
            else
                mq = System.Messaging.MessageQueue.Create(".\\google");

2. window form 默认情况下不可被非创建它的线程进行访问. 这个问题, 简单点的方法是允许它被其它线程访问:

Control.CheckForIllegalCrossThreadCalls = false;

但是这样其实会有一个跨线程访问的风险存在, 是非安全的. 建议的方法是通过delegate的方法, 让控件自己去invoke需要调用的方法, 是一种由被动修改变为主动出击的方式.

C# volatile

关于volatile关键字, 大家用的可能不多,  因为经常大家用的时候都是使用的lock, 或者其它的线程锁, 来避免并发时对变量的更改, 引用的不同步.

volatile 关键字, 是一个轻量级的lock, 它会进行更多的优化, 具体的优化哪些东西我也不清楚, 性能也要比lock方式好. 所以一般情况下, 使用volatile即可. 下面摘取msdn 上对于这个关键字的描述:

volatile 关键字指示一个字段可以由多个同时执行的线程修改。 声明为 volatile 的字段不受编译器优化(假定由单个线程访问)的限制。 这样可以确保该字段在任何时间呈现的都是最新的值。

volatile 修饰符通常用于由多个线程访问但不使用 lock 语句对访问进行序列化的字段。

using System;
using System.Threading;

public class Worker
{
    // This method is called when the thread is started.
    public void DoWork()
    {
        while (!_shouldStop)
        {
            Console.WriteLine("Worker thread: working...");
        }
        Console.WriteLine("Worker thread: terminating gracefully.");
    }
    public void RequestStop()
    {
        _shouldStop = true;
    }
    // Keyword volatile is used as a hint to the compiler that this data
    // member is accessed by multiple threads.
    private volatile bool _shouldStop;
}

public class WorkerThreadExample
{
    static void Main()
    {
        // Create the worker thread object. This does not start the thread.
        Worker workerObject = new Worker();
        Thread workerThread = new Thread(workerObject.DoWork);

        // Start the worker thread.
        workerThread.Start();
        Console.WriteLine("Main thread: starting worker thread...");

        // Loop until the worker thread activates.
        while (!workerThread.IsAlive) ;

        // Put the main thread to sleep for 1 millisecond to
        // allow the worker thread to do some work.
        Thread.Sleep(1);

        // Request that the worker thread stop itself.
        workerObject.RequestStop();

        // Use the Thread.Join method to block the current thread 
        // until the object's thread terminates.
        workerThread.Join();
        Console.WriteLine("Main thread: worker thread has terminated.");
    }
    // Sample output:
    // Main thread: starting worker thread...
    // Worker thread: working...
    // Worker thread: working...
    // Worker thread: working...
    // Worker thread: working...
    // Worker thread: working...
    // Worker thread: working...
    // Worker thread: terminating gracefully.
    // Main thread: worker thread has terminated.
}


VIM 基本命令

VIM For windows默认安装后,在桌面上会有2个Shortlink, 但是这2个link都是带有参数的, 一个是/y, 进去以后就是insert模式, 非常不方便。 一个是/R, 进去以后永远是Readonly, 无法更改数据。 所以我们需要直接将gvim.exe建立快捷方式至桌面, 并且copy 一份到system32, 以便于命令行直接启动。

Linux下的vim命令, 大多在windows下也可以使用, 这里截取了一段来自网上的Vim commands.

Continue reading “VIM 基本命令”

x509

x509证书一般会用到三类文件,key,csr,crt。

Key是私用密钥,openssl格式,通常是rsa算法。

csr是证书请求文件,用于申请证书。在制作csr文件的时候,必须使用自己的私钥来签署申请,还可以设定一个密钥。

crt是CA认证后的证书文件(windows下面的csr,其实是crt),签署人用自己的key给你签署的凭证。

1.key的生成

openssl genrsa -des3 -out server.key 2048

这样是生成rsa私钥,des3算法,openssl格式,2048位强度。server.key是密钥文件名。为了生成这样的密钥,需要一个至少四位的密码。可以通过以下方法生成没有密码的key:

openssl rsa -in server.key -out server.key

server.key就是没有密码的版本了。

2.生成CA的crt

openssl req -new -x509 -key server.key -out ca.crt -days 3650

生成的ca.crt文件是用来签署下面的server.csr文件。

3.csr的生成方法:

openssl req -new -key server.key -out server.csr

需要依次输入国家,地区,组织,email。最重要的是,有一个common name,可以写你的名字或者域名。如果为了https申请,这个必须和域名吻合,否则会引发浏览器警报。生成的csr文件交给CA签名后形成服务端自己的证书。

4.crt生成方法

CSR文件必须有CA的签名才可形成证书. 可将此文件发送到verisign等地方由它验证,要交一大笔钱,何不自己做CA呢.

openssl x509 -req -days 3650 -in server.csr -CA ca.crt -CAkey server.key

-CAcreateserial -out server.crt

输入key的密钥后,完成证书生成。

-CA 选项指明用于被签名的csr证书,

-CAkey 选项指明用于签名的密钥。

-CAserial 指明序列号文件,而-CAcreateserial指明文件不存在时自动生成。

最后生成了私用密钥:server.key和自己认证的SSL证书:server.crt

Ubuntu+LAMP+Nginx

好久没有玩linux了, 下午的时候有点时间, 搭了一套环境.

使用的VMware workstation安装的Ubuntu 12 Server, 网络连接使用的NAT, Remove掉了Floppy.

Host是Intel Core i5-4570 3.2GHz的64Bit CPU, Memory 是4G. 配置还可以, 故给VMware配置了1G的Memory, 20G的Disk.

Ubuntu的安装过程现在是越来越简单了, 过程也记不清了, 这里就不说了.  总之顺利安装成功.

Host 的IP是 192.168.82.81, Client的IP是192.168.206.129.

因为Company里有Security Audit, 所以需要通过Proxy才能上外网, 故第一步给Ubuntu设置代理服务器.

editor /etc/profile

添加:

http_proxy=http://192.168.88.80:3128
https_proxy=http://192.168.88.80:3128
ftp_proxy=http://192.168.88.80:3128
export http_proxy https_proxy ftp_proxy

然后Reboot.

OK, 可以上外网了. 现在开始更新apt源, 由于默认安装后的源是Ubuntu在国外的服务器, 非常慢, 所以先更改源地址:

editor /etc/apt/sources.list

然后在所有的archive.ubuntu.com前加上cn., 即: http://cn.archive.ubuntu.com/ubuntu/ , cn.archive.ubuntu.com 是由阿里巴巴维护的, 放在阿里云上, 速度是很快的.

下面开始 update source list:

atp-get update

下面开始安装VIM, 使用Editor编辑器实在不顺手:

apt-get install vim

下面开始安装LAMP:

tasksel install lamp-server

下面开始安装Nginx:

apt-get install nginx

下面开始安装phpMyAdmin:

apt-get install phpmyadmin

至此nginx+lamp+phpmyadmin安装结束. 现在要开始进行配置.

因为nginx会占用80端口, 所以apache将无法启动, 因为nginx是进行对外公布的load blancing, 所以nginx会占用80和443 两个端口. 所以先来修改apache的端口, 以及启用apache对于SSL的支持.

vim /etc/apache/prots.conf

将apache的监听http协议的端口改为8080, SSL协议的端口改为4433

NameVirtualHost *:8080
Listen 8080
NameVirtualHost *:4433

<IfModule mod_ssl.c>
Listen 4433
</IfModule>
<IfModule mod_gnutls.c>
Listen 4433
</IfModule>

然后切换目录到/etc/apache2/mods-enabled/

cd /etc/apache2/mods-enabled/

执行命令下面命令, 以启用apache对于SSL的支持:

ln -s ../mods-available/ssl.conf
ln -s ../mods-available/ssl.load

然后将apache自带的ssl站点进行启用:

cd /etc/apache2/sites-enabled/
ln -s ../sites-available/default-ssl

然后对000-default和default-ssl这2个virtual host进行端口更改:

vi /etc/apache2/sites-enabled/000-default
vi /etc/apache2/sites-enabled/default-ssl

将000-default中的VirtualHost *:80改为VirtualHost *:8080, 将default-ssl中的VirtualHost *:443改为VirtualHost *:4433

在Host上使用IE打开Http://192.168.206.129:8080和https://192.168.206.129:4433, 如果都可以打开, 说明apache的配置成功.

现在来配置nginx, 使其进行反向代理和负载均衡:

vi /etc/nginx/sites-enabled/default

需要分别配置http和https的load blancing, 其中192.168.82.81是Host上安装的IIS:

upstream loadblancing{
server 192.168.82.81:80;
server 127.0.0.1:8080;
}

upstream loadblancingssl{
server 192.168.82.81:443;
server 127.0.0.1:4433;
}

然后在server节点里, 将location节点修改为:

location /{
proxy_pass http://loadblancing;
}

然后定位到文件末页, 将关于Https Server的注释符号”#” 全拿掉, 使其启用.

并且将其location节点修改为:

location / {
https://loadblancingssl;
}

另外, 需要将ssl证书和key的位置进行修改, 在后面我们需要创建open ssl 证书:

ssl_certificate /root/server.crt;
ssl_certificate_key /root/server.key;

现在来创建openssl证书, 首先来创建私钥, 创建私钥的过程中会要求输入密码:

openssl
genrsa -aes256 -out server.key 1024

创完私钥, 来创建证书的请求文件:

openssl
req -new -key server.key -out server.csr

请求文件创建成功后, 我们来把私钥做个备份:

cp server.key server.key.bak

我们把带密码的key取消掉口令, 以便Nginx可以正常使用:

openssl
rsa -in server.key.bak -out server.key

然后我们使用x509来颁发证书, 得到证书文件server.crt :

openssl
x509 -req -days 365 -in server.csr -signkey server.key -out server.crt

现在我们来重启Nginx:

/etc/init.d/nginx restart

OK, 结束. 现在可以在host上打开IE, 浏览http://192.168.206.129和https://192.168.206.129, 会发现相同的URL在点击刷新后, 不断出现不同的页面, 这是因为一个是Client上的Apache首页, 一个是Host上的IIS首页.


统计信息, SQLServer自动更新和自动创建统计信息选项

统计信息是如何提高SQLServer查询性能的?统计直方图用作在查询执行计划中查询优化器的选择依据。如果一个查询谓词包含统计信息的列,那么查询优 化器不需要预测该查询中影响行数,因此,查询优化器有足够的信息去创建执行计划。SQLServer创建执行计划有一下几种不同的方式:

  • 统计信息会在每个新创建的索引中自动创建统计信息。
  • 如果数据库中AUTO_CREATE_STATISTICS被设置为ON,SQLServer将会自动对查询中用到的,且没有索引的列自动创建统计信息。

AUTO_CREATE_STATISTICS选项:

当把该选项设为ON时,查询优化器会对在谓词中使用的到列,如果这些列的统计信息不可用,则会单独对每列创建统计信息。这些统计信息对创建一个查询 计划非常必要。它们创建于那些现有统计对象中不存在直方图的列上,名字包括列名和对象ID的十六进制格 式:_WA_Sys_<column_name>_<XXXX>。这些统计信息用于查询优化器决定使用何种优化后的执行计划。

可以通过以下语句启用自动统计信息创建功能:

ALTER  DATABASE[你的库名]

SET AUTO_CREATE_STATISTICS ON

Auto Update Statistics选项:

统计信息会在查询编译或者执行缓存执行计划前被检查。当在以下情况下,统计信息会被认为过期:

1、  在一个空表中有数据的改动。

2、  当统计信息创建时,表的行数只有500或以下,且后来统计对象中的引导列的更改次数大于500.

3、  当表的统计信息收集时,超过了500行,且统计对象的引导列后来更改次数超过500+表总行数的20%时。

4、  在Tempdb中的表,少于6行且最少有6行被更改。 Continue reading “统计信息, SQLServer自动更新和自动创建统计信息选项”

Asp.Net MVC温故而知新【14】- Details 和 Delete 方法详解

  1. Asp.Net MVC温故而知新【1】-添加控制器
  2. Asp.Net MVC温故而知新【2】-添加视图
  3. Asp.Net MVC温故而知新【3】- 修改视图和布局页
  4. Asp.Net MVC温故而知新【4】- 控制器传递数据给视图
  5. Asp.Net MVC温故而知新【5】- 添加模型
  6. Asp.Net MVC温故而知新【6】- 创建连接字符串
  7. Asp.Net MVC温故而知新【7】- 通过控制器访问模型的数据
  8. Asp.Net MVC温故而知新【8】- 生成的代码详解
  9. Asp.Net MVC温故而知新【9】- 使用 SQL Server LocalDB
  10. Asp.Net MVC温故而知新【10】- Edit方法和Edit视图详解
  11. Asp.Net MVC温故而知新【11】- 添加查询
  12. Asp.Net MVC温故而知新【12】- 数据迁移之添加字段
  13. Asp.Net MVC温故而知新【13】- 添加验证
  14. Asp.Net MVC温故而知新【14】- Details 和 Delete 方法详解

下一个项目使用Asp.Net MVC技术进行开发,以前也用过,好几年没用了,今天没事便找了个教程,复习了一下,是Asp.Net MVC4框架,觉得浅显易懂,便复制收藏了。

在教程的这一部分,我们将研究一下自动生成的 Details 和Delete 方法。

Details 方法

打开Movie控制器,找到Details方法。

//
// GET: /Movies/Details/5
public ActionResult Details(Int32 id)
{
    Movie movie = db.Movies.Find(id);
    if (movie == null)
    {
        return HttpNotFound();
    }
    return View(movie);
}

Code First 通过使用Find方法找到要显示的Movie对象。如果movie对象为null,则返回HttpNotFound(),这个判断非常有必要,试想如果有黑客要攻击你的网站,他们可能将通过修改URL来尝试访问你的网站,例如将http://localhost:xxxx/Movies/Details/1 修改为http://localhost:xxxx/Movies/Details/12345 。如果你不去验证movie是否为空,则会将数据库错误返回给黑客,这样会暴漏网站的更多信息。

Delete 和 DeleteConfirm 方法

//
// GET: /Movies/Delete/5
public ActionResult Delete(Int32 id)
{
    Movie movie = db.Movies.Find(id);
    if (movie == null)
    {
        return HttpNotFound();
    }
    return View(movie);
}

//
// POST: /Movies/Delete/5
[HttpPost, ActionName("Delete")]
[ValidateAntiForgeryToken]
public ActionResult DeleteConfirmed(Int32 id)
{
    Movie movie = db.Movies.Find(id);
    db.Movies.Remove(movie);
    db.SaveChanges();
    return RedirectToAction("Index");
}

第一个Delete方法并没有删除Movie,而是返回了可以删除确认页面,在确认页面中,会创建HttpPost请求,完成Movie的删除。直接使用HttpGet 请求来删除Movie会打开一个安全漏洞。

真正删除数据的方法名字是 DeleteConfirmed。下面是两个方法的定义:

public ActionResult Delete(Int32 id)

[HttpPost, ActionName("Delete")]
[ValidateAntiForgeryToken]
public ActionResult DeleteConfirmed(Int32 id)

CLR对于重构的方法,要求方法名相同,但参数不同。然而,我们在这里用到的两个删除方法,他们都接收一个整形的参数,如果方法名也形同,那么就构成语法错误了。

为了解决这个问题,有以下几种解决办法:

第一种办法是使用不同的方法名。这也是ASP.NET MVC 5 支架所采用的方法。然而,使用这种方法还有一些小问题:ASP.NET 通过地址段来映射方法名,如果将方法重命名,路由通常会找不到方法,解决的办法已经在上面的例子中了,我们可以为DeleteConfirmed方法添加特性ActionName(“Delete”)。这样一来,当URL中包含Delete 的POST请求都会被分配给方法DeleteConfirmed。

另外一种常用解决的方法是使用相同的名字,然后为POST 方法添加一个未使用的参数。例如,一些开发者会添加FormCollection类型的参数传递给POST方法,然后不使用这个参数:

public ActionResult Delete(FormCollection fcNotUsed, int id = 0)
{
    Movie movie = db.Movies.Find(id);
    if (movie == null)
    {
        return HttpNotFound();
    }
    db.Movies.Remove(movie);
    db.SaveChanges();
    return RedirectToAction("Index");
}


总结

现在你已经拥有了一个完整的ASP.NET MVC 5 应用程序,你可以使用LocalDB来存储数据,可以新建、编辑、查找、删除 Movie数据。